Redis 学习笔记
Redis
Redis (REmote DIctionary Server) :用 C 语言开发的一个开源的高性能键值对(key-value)数据库。
特征:
- 数据间没有必然的关联关系,不存关系,只存数据
- 数据存储在内存,存取速度快,解决了磁盘 IO 速度慢的问题
- 内部采用单线程机制进行工作
- 高性能,官方测试数据,50个并发执行100000 个请求,读的速度是110000 次/s,写的速度是81000次/s
- 多数据类型支持
- 字符串类型:string(String)
- 列表类型:list(LinkedList)
- 散列类型:hash(HashMap)
- 集合类型:set(HashSet)
- 有序集合类型:zset/sorted_set(TreeSet)
- 支持持久化,可以进行数据灾难恢复
应用:
- 为热点数据加速查询(主要场景),如热点商品、热点新闻、热点资讯、推广类等高访问量信息等
- 即时信息查询,如排行榜、网站访问统计、公交到站信息、在线人数(聊天室、网站)、设备信号等
- 时效性信息控制,如验证码控制、投票控制等
- 分布式数据共享,如分布式集群架构中的 session 分离
- 消息队列
redis基本操作
读写数据:
设置 key,value :
1
set name cs
根据 key 查询对应的value,如果不存在,返回空(nil):
1
get name
数据类型
所有的key都为String类型,讨论数据类型是说的value的类型
1、String
基本操作
1 | //设置String |
2.hash
基本操作
1 | //插入(如果已存在同名的field,会被覆盖) |
3、List
基本操作
1 | //添加修改数据,lpush为从左边添加,rpush为从右边添加 |
4、Set
- 不重复且无序
基本操作
1 | //添加元素 |
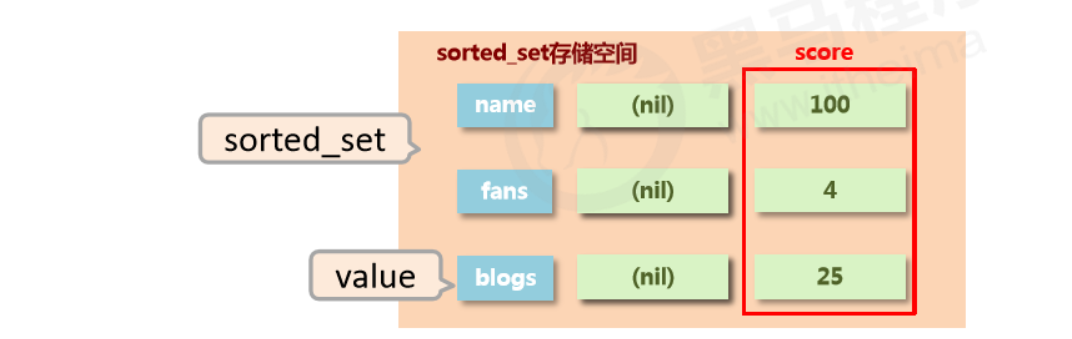
5、sorted_set
- 不重但有序(score)
- 新的存储需求:数据排序有利于数据的有效展示,需要提供一种可以根据自身特征进行排序的方式
- 需要的存储结构:新的存储模型,可以保存可排序的数据
- sorted_set类型:在set的存储结构基础上添加可排序字段
基本操作
1 | //插入元素, 需要指定score(用于排序) |
Redis持久化
利用永久性存储介质将数据进行保存,在特定的时间将保存的数据进行恢复的工作机制称为持久化。防止数据丢失。
持久化过程存什么:
将当前数据状态进行保存,快照形式,存储数据结果,关注点在数据——RDB
将数据的操作过程进行保存,日志形式,存储操作过程,存储格式复杂,关注点在数据的操作过程——AOF
RDB
save
save 指令:手动执行一次保存操作
工作原理:redis 是个单线程的工作模式,会创建一个任务队列,所有的命令都会进到这个队列排队执行。当某个指令在执行的时候,队列后面的指令都要等待,所以这种执行方式会非常耗时。
save 指令的执行会阻塞当前 Redis 服务器,直到当前 RDB 过程完成为止,有可能会造成长时间阻塞,线上环境不建议使用
bgsave
流程:当执行 bgsave 的时候,客户端发出 bgsave 指令给到 redis 服务器,服务器返回后台已经开始执行的信息给客户端,同时使用 fork 函数创建一个子进程,让子进程去执行 save 相关的操作。持久化过程是先将数据写入到一个临时文件中,持久化操作结束再用这个临时文件替换上次持久化的文件,在这个过程中主进程是不进行任何 IO 操作的,这确保了极高的性能
bgsave 分成两个过程:第一个是服务端收到指令直接告诉客户端开始执行;另外一个过程是 fork 的子进程在完成后台的保存操作,操作完以后返回消息。两个进程不相互影响,所以在持久化期间 Redis 可以正常工作
注意:bgsave 命令是针对 save 阻塞问题做的优化,Redis 内部所有涉及到 RDB 操作都采用 bgsave 的方式,save 命令可以放弃使用
自动
配置文件自动 RDB,无需显式调用相关指令,save 配置启动后底层执行的是 bgsave 操作
配置 redis.conf:
1 | save second changes #设置自动持久化条件,满足限定时间范围内key的变化数量就进行持久化(bgsave) |
参数:
- second:监控时间范围
- changes:监控 key 的变化量
说明: save 配置中对于 second 与 changes 设置通常具有互补对应关系,尽量不要设置成包含性关系
示例:
1 | save 300 10 #300s内10个key发生变化就进行持久化 |
判定 key 变化的原理:
- 对数据产生了影响
- 不进行数据比对,比如 name 键存在,重新 set name seazean 也算一次变化
save 配置要根据实际业务情况进行设置,频度过高或过低都会出现性能问题,结果可能是灾难性的
RDB三种启动方式对比:
| 方式 | save指令 | bgsave指令 |
|---|---|---|
| 读写 | 同步 | 异步 |
| 阻塞客户端指令 | 是 | 否 |
| 额外内存消耗 | 否 | 是 |
| 启动新进程 | 否 | 是 |
总结
RDB 特殊启动形式的指令(客户端输入)
服务器运行过程中重启
1
cdebug reload
关闭服务器时指定保存数据
1
shutdown savec
默认情况下执行 shutdown 命令时,自动执行 bgsave(如果没有开启 AOF 持久化功能)
全量复制:主从复制部分详解
RDB 优点:
- RDB 是一个紧凑压缩的二进制文件,存储效率较高,但存储数据量较大时,存储效率较低
- RDB 内部存储的是 redis 在某个时间点的数据快照,非常适合用于数据备份,全量复制等场景
- RDB 恢复数据的速度要比 AOF 快很多,因为是快照,直接恢复
RDB 缺点:
- bgsave 指令每次运行要执行 fork 操作创建子进程,会牺牲一些性能
- RDB 方式无论是执行指令还是利用配置,无法做到实时持久化,具有丢失数据的可能性,最后一次持久化后的数据可能丢失
- Redis 的众多版本中未进行 RDB 文件格式的版本统一,可能出现各版本之间数据格式无法兼容
应用:服务器中每 X 小时执行 bgsave 备份,并将 RDB 文件拷贝到远程机器中,用于灾难恢复
AOF
概念
- AOF(append only file)持久化:以独立日志的方式记录每次写命令,重启时再重新执行AOF文件中命令,以达到恢复数据的目的。与RDB相比可以简单描述为改记录数据为记录数据产生的过程
- AOF的主要作用是解决了数据持久化的实时性,目前已经是Redis持久化的主流方式
AOF写数据三种策略(appendfsync)
- always
- 每次写入操作均同步到AOF文件中,数据零误差,性能较低,不建议使用
- everysec
- 每秒将缓冲区中的指令同步到AOF文件中,数据准确性较高,性能较高 ,建议使用,也是默认配置
- 在系统突然宕机的情况下丢失1秒内的数据
- no
- 由操作系统控制每次同步到AOF文件的周期,整体过程不可控
AOF重写
作用
- 降低磁盘占用量,提高磁盘利用率
- 提高持久化效率,降低持久化写时间,提高IO性能
- 降低数据恢复用时,提高数据恢复效率
规则
进程内已超时的数据不再写入文件
忽略
无效指令
,重写时使用进程内数据直接生成,这样新的AOF文件
只保留最终数据的写入命令
- 如del key1、 hdel key2、srem key3、set key4 111、set key4 222等
对同一数据的多条写命令合并为一条命令
- 如lpush list1 a、lpush list1 b、 lpush list1 c 可以转化为:lpush list1 a b c
- 为防止数据量过大造成客户端缓冲区溢出,对list、set、hash、zset等类型,每条指令最多写入64个元素
如何使用
手动重写
1
bgrewriteaof
自动重写
1
2auto-aof-rewrite-min-size size
auto-aof-rewrite-percentage percentage
AOF自动重写
自动重写触发条件设置
1
2
3
4
//触发重写的最小大小
auto-aof-rewrite-min-size size
//触发重写须达到的最小百分比
auto-aof-rewrite-percentage percent自动重写触发比对参数( 运行指令info Persistence获取具体信息 )
1
2
3
4
//当前.aof的文件大小
aof_current_size
//基础文件大小
aof_base_size自动重写触发条件
Redis事务
定义:redis事务就是一个命令执行的队列,将一系列预定义命令包装成一个整体(一个队列)。当执行时,一次性按照添加顺序依次执行,中间不会被打断或者干扰。
事务的基本操作
- 开启事务:multi
- 取消事务:discardc
- 执行事务:exec
事务操作的注意事项
定义事务的过程中,命令格式输入错误:整体事务中所有命令均不会执行**。包括那些语法正确的命令
定义事务的过程中,命令执行出现错误(例如对list进行incr操作):能够正确运行的命令会执行,运行错误的命令不会被执行
分布式锁
1 | //上锁 |